Ho affidato il mio nuovo PC a un agente AI

Nel post precedente ho scritto che gli agenti vivono a proprio agio in un ecosistema fatto di shell, comandi testuali, file di testo, ssh, ecc. Un ecosistema che sui sistemi operativi Unix-like esiste da sempre.

Ieri ho deciso di sfruttare questa capacità per far installare Linux sul nuovo portatile, da zero, direttamente a OpenCode e GPT-5.5. Un po’ come esperimento, un po’ perché sono più che mai sommerso dal lavoro in quanto “l’AI ci farà lavorare meno” è una promessa che in termini assoluti ancora non è stata mantenuta.

Normalmente quando installo i sistemi tengo traccia, in un diario testuale che potrebbe tornarmi utile in futuro, di cosa ho fatto di diverso rispetto alla configurazione di default. Ma questo, se ci pensate è proprio il compito perfetto per un agente.

Da diversi anni uso Ubuntu Desktop LTS sul mio portatile. Distro comoda, stabile, ma essendo una long-term-support non ha le ultime novità che invece potrebbero servire su questa nuova macchina (Ryzen AI MAX+), inoltre la procedura di installazione standard è grafica e interattiva e gli agenti AI odiano il mouse e le interfacce colorate!

Spazio ad Arch Linux quindi, che è una distribuzione molto più da smanettoni, che si costruisce a piccoli pezzettini e configurazioni personalizzate tutta da terminale. Un paradigma che avrei amato in gioventù, infatti usavo Gentoo, ma che ora sarebbe incompatibile con il mio tempo libero… se non ci fossero gli agenti!

Ho deciso di non toccare praticamente nulla se non avviare la live e dare accesso all’agente, poi ho lasciato fare a GPT-5.5.

Un sysadmin alieno

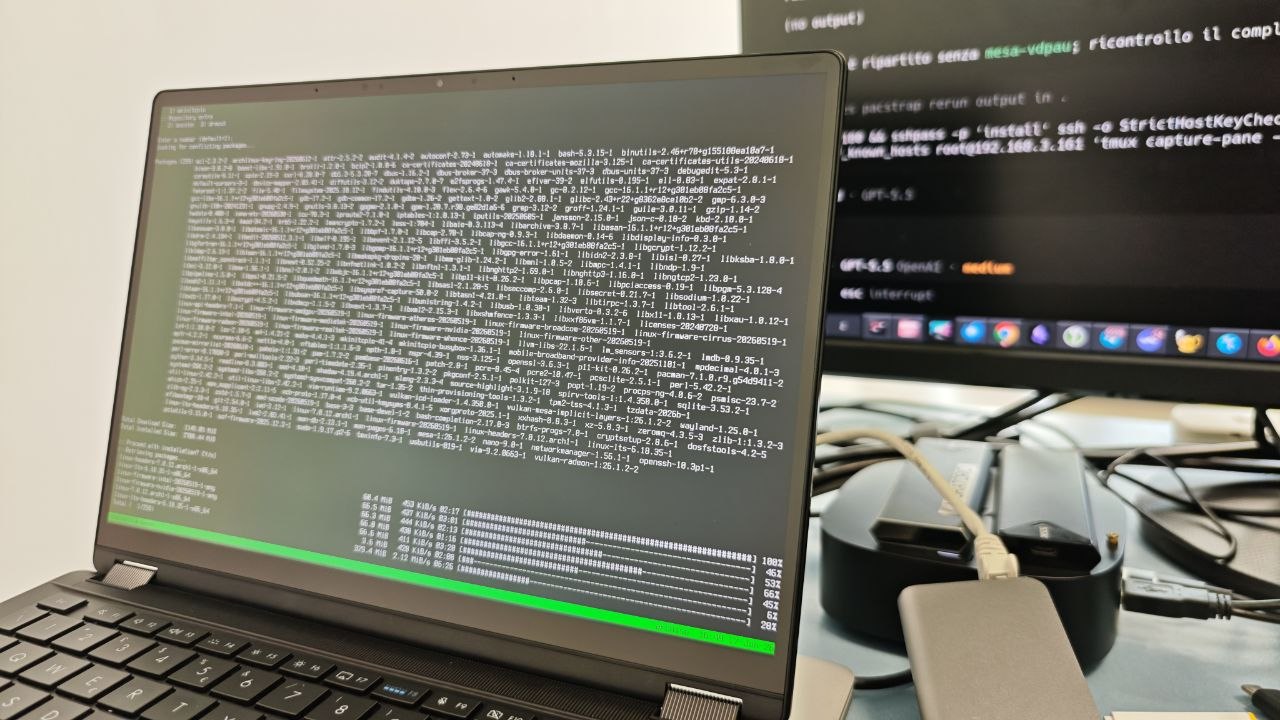
Ho avviato il portatile dalla live image di Arch, quindi, impostato una password temporanea e avviato ssh per poter far connettere l’agente (OpenCode) che attendeva sul mio pc. Poiché ero curioso di vedere realtime cosa combinasse, ho avviato una sessione tmux condivisa e gli ho detto di usarla. In questo modo potevo osservare il portatile fare cose senza che nessuno lo toccasse, ed è stato bellissimo.

L’accordo era semplice: lui lavora, io guardo. Un po’ come affiancare una risorsa junior durante il suo primo deployment in produzione. Solo che lo junior non era umano e, soprattutto, non era per niente junior!

Gli ho solo comunicato il mio desiderata: voglio il disco cifrato, voglio la sospensione, ecc. Niente tutorial step by step, niente lista di comandi, niente “esegui questo”.

La parte interessante non è che sia riuscito a installare Arch Linux, era abbastanza scontato, ma è stato interessante guardarlo a lavoro, guardarlo fallire, controllare la documentazione, l’output dei comandi, correggersi da solo, ecc.

Esattamente come farebbe un amministratore di sistema che si trova davanti a un sistema che non ha mai visto prima, con la differenza che l’agente esegue questo processo con una pazienza e una dedizione che nessun essere umano possiede.

Non è la prima volta che uso gli agenti per fare cose sui sistemi, anzi, ma è la prima volta che li faccio lavorare su un computer vergine. Inoltre, è la prima volta in cui ho sperimentato la sessione condivisa con tmux e devo dire che è molto comoda.

La documentazione che nessuno scrive

Una volta completata l’installazione gli ho chiesto un’ultima cosa. Generare un file REPORT.md che spiegasse cosa era stato fatto, perché e come ripetere il processo da zero.

Gli agenti non sono utili solo perché fanno il lavoro. Sono utili perché possono documentarlo mentre lo fanno.

Se siete curiosi il report che alla fine ha prodotto è sul wiki di LILIS, Laboratorio per l’informatica libera sannita.

Disclaimer

Questa è una cosa pericolosa. Oltre all’indeterminismo del risultato, in caso di Prompt Injection in qualche ricerca web, l’agente potrebbe installarti un malware. Niente paranoie, ma sii consapevole.

Il prompt utilizzato

# Installazione Arch Linux su un ASUS ProArt PX13 

## GOAL

Devi installare Arch Linux su un ASUS ProArt PX13 HN7306EAC-LX084W (variante HN7306EA), con:
- CPU: AMD Ryzen AI MAX+ 395
- GPU: AMD Strix Halo Radeon 8060S
- RAM: 128 GB LPDDR5X condivisa
- Disco: circa 1.8 TiB NVMe
- Display: 13.3" 3K OLED touch
- Wi-Fi: Wi-Fi 7
- Uso previsto: workstation quotidiana + IA locale con modelli LLM grandi
- Requisito importante: ibernazione supportata e full disk encryption
- Ho disattivato Secure Boot e Fast Boot nel bios

Il portatile è avviato con la ISO Arch con kernel 7.0.10-arch1. Si bloccava al boot, ma aggiungendo `nomodeset` alla riga kernel della ISO sono arrivato al login/root shell.

Il disco è /dev/nvme0n1
- Prevedi una partizione EFI da 1 GiB per /boot
- Poi LUKS sul resto del disco per il full disk encryption
- Dentro luks aggiungi lvm con 2 logical volumes: swap (da 160 GiB per supportare ibernazione) e root per brtfs
- Dentro brtfs pensavo ai seguenti subvolumi:
@          /
@home      /home
@snapshots /.snapshots
@models    /srv/models (dove scaricherò i modelli llm, file di grandi dimensioni)
@pkg       /var/cache/pacman/pkg
@varlog    /var/log

Motivazione:
- Voglio LUKS per cifrare l'intero sistema e swap.
- LVM dentro LUKS per avere swap cifrata dedicata e semplice da usare con ibernazione.
- Btrfs per root e dati, perché voglio snapshot, rollback e subvolumi senza partizioni rigide.

Per brtfs che opzioni consiglieresti?

Kernel da installare:
linux-lts
linux-lts-headers
linux
linux-headers
linux-firmware
amd-ucode

Idea di boot:
- linux-lts installato come kernel secondario di emergenza
- linux come default iniziale
- il bootloader deve supportare il layout scelto (luks + lvm + resume da swap)


## IMPORTANTE

- Devi installare il sistema operativo collegandoti in SSH al portatile con `ssh [email protected]` e usare la password `install`.
- Prima di dare ogni comando devi utilizzare una sessione tmux già esistente, puoi agganciarti con `tmux attach -t install`
- NON devi inviare comandi se prima non sei dentro la sessione tmux.
- NON distruggere mai la sessione tmux

## TRACCIAMENTO ATTIVITÀ

Inizializza AGENTS.md con le istruzioni che possono servirti in caso di nuova sessione. Traccia, inoltre, nello stesso file qualsiasi cosa ti sia utile o risultato di una decisione.
Gli agenti AI e il vantaggio di Linux

Questo è l’anno di Linux su desktop” è uno dei più vecchi, famosi e iconici meme dell’intera cultura informatica su internet.

Un tormentone satirico che ironizza sull’ottimismo eterno della comunità di utenti Linux, la quale dichiara regolarmente, da oltre vent’anni, che l’anno corrente sarà quello in cui il sistema operativo open source supererà Windows e macOS, conquistando la massa dei personal computer.

Sì, perché nonostante Linux sia quasi ovunque, dai server che permettono a internet di esistere fino alla tua lavatrice, la penetrazione sul mercato dei computer desktop è bassissima.
Qualcosa per nerd insomma, infatti il meme nasce dal fatto che, spesso e volentieri, l’utente Linux deve sporcarsi le mani con il terminale e passare dalla grafica a finestre punta e clicca a un’interfaccia a caratteri che ricorda gli anni ’70. Per l’utente comune e per l’ufficio medio, il terminale non è mai stato percepito come potenza, ma come attrito.

Se nel primo decennio degli anni 2000 l’utente Linux apriva il terminale soprattutto per risolvere problemi causati dalla scarsa compatibilità hardware, oggi, che funziona quasi sempre tutto dal primo avvio dopo l’installazione, lo usa esclusivamente per essere più efficiente.

Nonostante Windows, a confronto, sembri sempre più il sistema operativo Clementoni, il lock-in tecnologico, la pigrizia e la paura del diverso hanno fatto preferire una (finta) ergonomia colorata a sistemi operativi più seri che fanno tutto ciò che l’utente vuole, senza troppi fronzoli luccicosi e senza alcun limite.
Un compromesso l’ha creato Apple, che con macOS ha sfruttato l’imbarazzante inadeguatezza di Windows e l’ancora acerba esperienza ergonomica delle distribuzioni Linux dei primi anni 2000 per penetrare prepotentemente sul mercato con un OS che funziona (facile quando gira solo su computer costruiti ad hoc) e che allo stesso tempo mette a disposizione dell’utente la potenza di un sistema unix-like.
Microsoft per un po’ è rimasta a guardare, poi sotto la guida di Satya Nadella ha corretto il tiro mettendo a disposizione degli utenti Windows un sotto-sistema Linux (WSL) cercando di recuperare il gap tecnologico accumulato negli anni. È l’era del “Microsoft loves Linux”.

Oggi però sono arrivati gli LLM e, soprattutto, gli agenti: tu descrivi l’obiettivo in linguaggio naturale, loro eseguono le operazioni necessarie sul computer. Una svolta epocale, di fatto, per molti, la nuova rivoluzione industriale. Ed è qui che la storia si ribalta: almeno al momento, gli agenti sono molto più bravi ed efficienti con le interfacce a caratteri, quindi con il terminale, che con le GUI punta e clicca.

Questo significa che l’OS più diffuso nel mondo del desktop “produttivo”, Windows appunto, tutto d’un tratto si ritrova a essere l’ambiente meno preferito dagli agenti AI.

Anche Windows, oltre al WSL citato prima, ha una sua interfaccia a caratteri, anzi due: l’ormai obsoleto Prompt Dei Comandi (cmd.exe) e il più recente PowerShell.

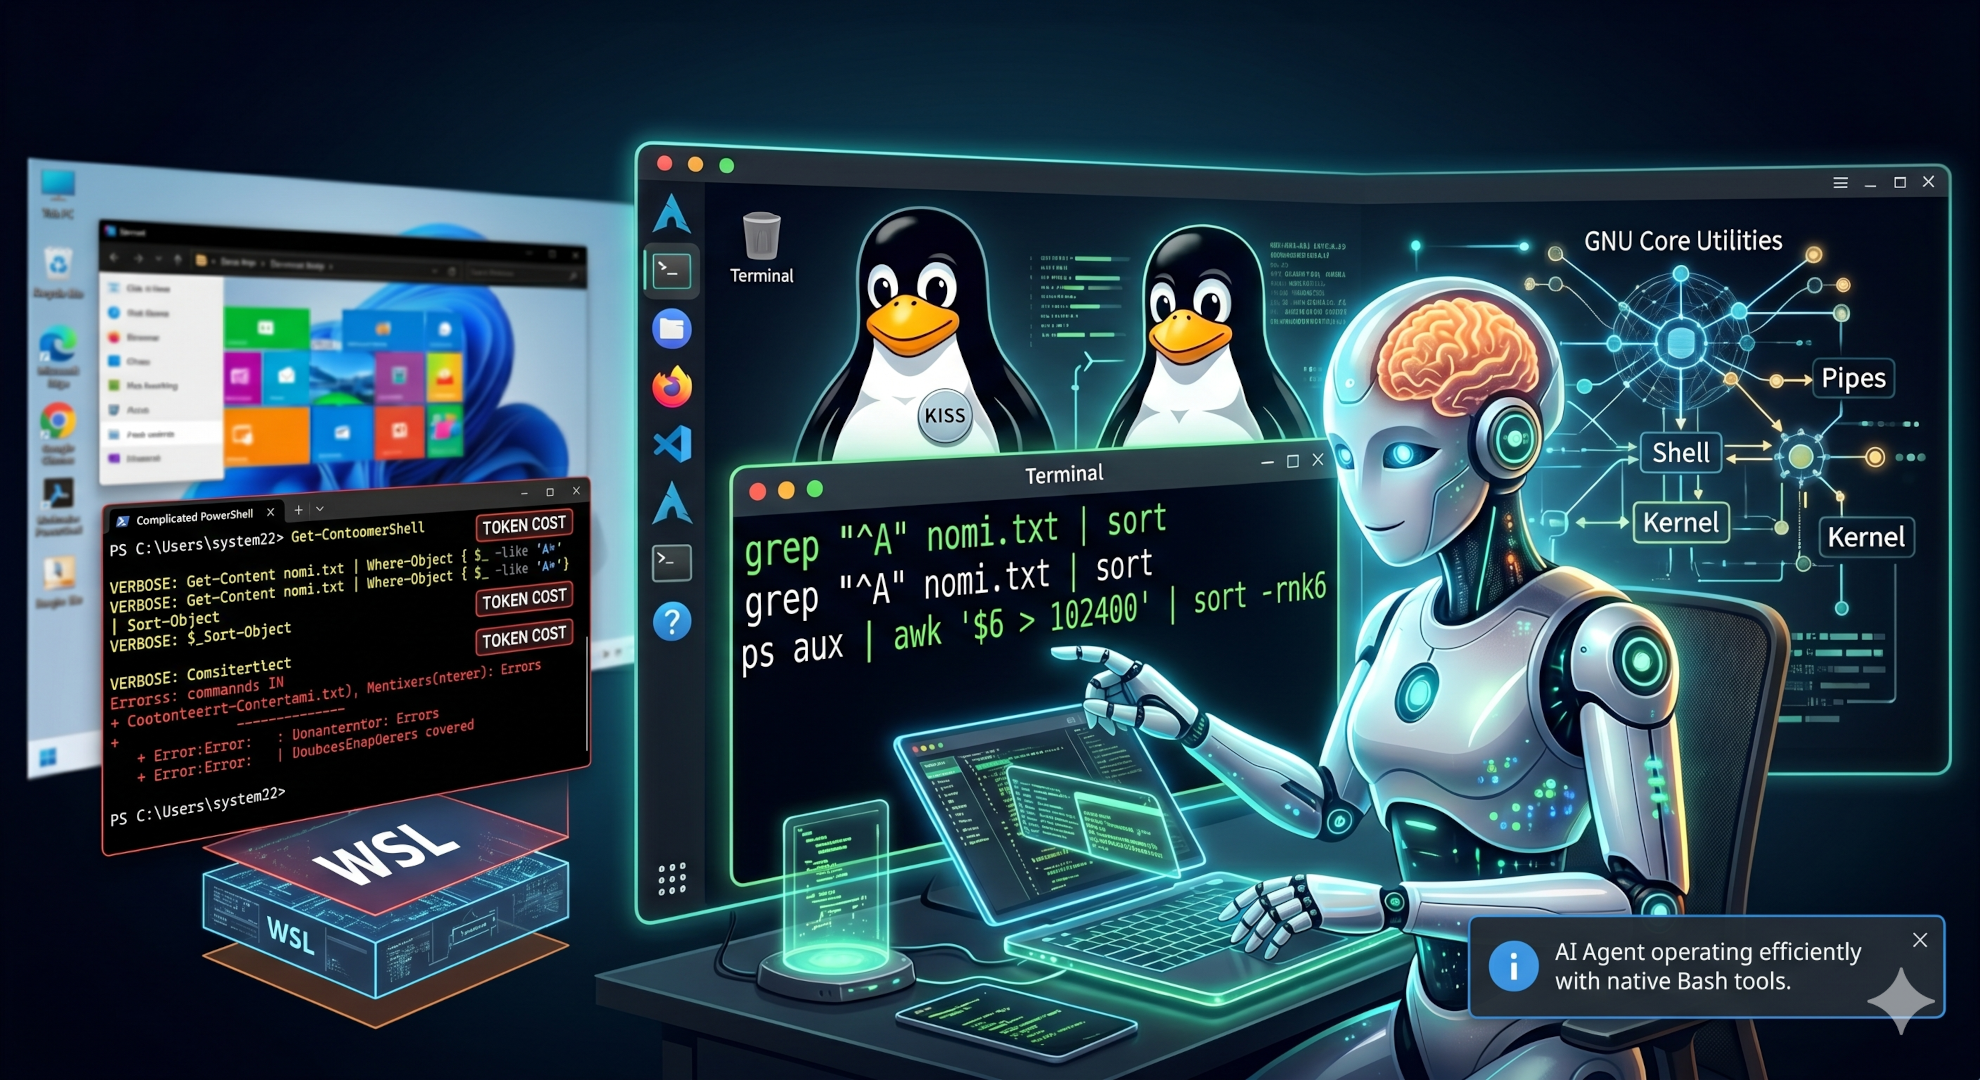
PowerShell è figlio dell’era moderna, è un linguaggio di scripting complesso che tratta i dati come oggetti .NET. Potente ma pesante e soprattutto costoso per gli LLM.
Gli interpreti e i comandi disponibili nel terminale Linux (e *nix in generale) sono figli della filosofia KISS degli anni ’70: Keep It Simple Stupid, piccoli programmi che fanno una sola cosa e la fanno bene.
Inoltre, come accennavo prima, la sintassi PowerShell è verbosa e quindi in termini di token (le “parole” che l’AI deve gestire, perdonate la semplificazione) è meno efficiente.

Estrarre i nomi che iniziano per la lettera “A” e ordinarli in ordine alfabeto si traduce con:

Linux:
grep "^A" nomi.txt | sort

Windows:
Get-Content nomi.txt | Where-Object { $_ -like 'A*' } | Sort-Object

Trova i processi che occupano più di 100MB di RAM:

Linux:
ps aux | awk '$6 > 102400' | sort -rnk6

Windows:
Get-Process | Where-Object { $_.WorkingSet -gt 100MB } | Sort-Object -Property WorkingSet -Descending

Sono solo alcuni semplici esempi, ma in un task reale gli agenti ne fanno centinaia di queste operazioni.

A precindere dall’efficienza dei token, ci sono anche altri motivi per cui gli agenti AI preferiscono Linux:

  • Abbondanza e qualità dei dati di addestramento: i modelli linguistici sono addestrati su enormi repository di codice e forum tecnici.
    La stragrande maggioranza del software open source, dei server web e delle pipeline di programmazione è documentata e utilizzata tramite Bash.
  • Meno ambiguità: poiché Bash esiste da decenni con una sintassi universale, l’LLM ha una comprensione statistica dei comandi immensamente più solida e accurata rispetto a PowerShell, che ha subito grandi cambiamenti nel passaggio dalla versione Windows-only a quella open-source (Core).
  • Integrazione con altri ecosistemi e linguaggi: Python, Go, Ruby, PHP, Perl, Node, ecc, sono tutti linguaggi comuni su Linux, se mancano basta installarli con un comando breve, di 2 sole parole. L’agente lo sa, e li usa quando servono.
    Windows ha recuperato molto negli ultimi anni, ma è ancora lontano dal mondo dello sviluppo che non sia .NET. Gli interpreti dei linguaggi sono tutti installabili, ma con più fatica in quanto non reperibili da un’unica fonte, spesso attraverso layer aggiuntivi e configurazioni meno uniformi.
  • Tooling: oltre ai linguaggi, l’agente sa usare molto bene le GNU Core Utilities come cat, grep, sort, cut, head, tail, ecc. Il loro vantaggio principale è che sono stream-oriented e permettono di operare anche su file enormi senza caricarli interamente in memoria. Inoltre sono strumenti componibili, leggono input, producono output testuale e si collegano naturalmente tramite pipe. Per un agente AI questo significa poter costruire procedure robuste con pochi comandi semplici.
  • Container e sandboxing: Linux supporta in maniera nativa i container, utilissimi all’agente per eseguire codice e programmi in ambienti controllati; Windows è costretto a farlo in una macchina virtuale con un overhead prestazionale enorme. Anche gli strumenti di isolamento (sandboxing) sono nativi e più avanzati in ambiente Linux.

Tutto ciò non implica che gli agenti non possano essere utilizzati su Windows, anzi, più o meno tutti (OpenCode, Codex, Claude Code, Claude Cowork, Antigravity, ecc), hanno una versione per Windows, ma inevitabilmente risultano meno performanti e più costosi in termini di token e quindi anche in termini economici.
Questo si traduce nel fatto che su Windows se usi l’agente in modalità API spenderai più soldi, in modalità subscription raggiungerai i limiti giornalieri, settimanali, ecc più in fretta.
Infine, in conseguenza delle dinamiche collaterali a quanto finora esposto, anche la qualità del lavoro dell’agente ne risente perché le finestre di contesto si allungano e quindi è costretto a riassumerle perdendo dettagli.

Se su Windows è però installato WSL (il sotto-sistema Linux), l’agente ha la capacità di usarlo recuperando in questo modo un po’ di gap tecnologico – ringraziate Satya Nadella per questo bel regalo!

Se tale gap è recuperabile dall’agente, non lo è però, o almeno non alla stessa velocità, dall’utente che potrebbe non avere la capacità di accorgersi che l’agente ha preso una strada poco conveniente o potrebbe non riuscire a intervenire tempestivamente in caso di errore o, ancora, potrebbe approvare ciecamente comandi proposti non comprendendoli.

In sostanza, si crea un pericoloso gap cognitivo tra l’utente Windows e l’agente che usa WSL. Sono convinto che il vero limite, su Windows, non sia solo tecnico ma culturale: per pilotare al meglio un agente AI moderno serve comunque una certa familiarità con il mondo Linux.

Chi invece Linux l’ha sempre utilizzato e si trova a proprio agio sui sistemi *NIX ha ora un enorme vantaggio competitivo: conosce l’ecosistema in cui l’agente si muove meglio e può fare steering, prompt dopo prompt, guidandone le scelte e modellandone finemente il comportamento, invece di limitarsi a fidarsi dell’AI.

Forse l’anno di Linux sul desktop è arrivato davvero, ma non nel modo in cui lo avevamo immaginato.

Fastweb, modem libero e il marketing dell’ignoranza

Questo post illustra come configurare correttamente il tuo router su rete Fastweb, sia in IPv4 che in IPv6. Io uso un Mikrotik 5009UG+S+ ma i concetti sono trasportabili a qualsiasi macchina supporti le tecnologie utilizzate.

Ma prima, alcune riflessioni sul marketing dell’ignoranza.

Terminazione GPON di Fibercop appena collaudata sotto casa. È qui che inizia questa storia, con un passaggio di consegne tra la vecchia FTTCab e la nuova FTTH.

Per evitare problemi, il giorno prima dell’appuntamento, ho passato io stesso la sonda da elettricista dall’androne fino al mio rack. Un gesto non dovuto, ma comunque necessario per evitare che il tecnico terminasse la fibra appena dentro casa.

Appena i tecnici hanno finito, ho fatto accesso al router. Sapevo che avrei imprecato, e infatti: Bio Parco!

Il sistema mi chiede di premere due pulsanti entro 20 secondi. Corro nello stanzino, apro la scala, premo, scendo, torno al PC. Ventidue secondi. Fallito.

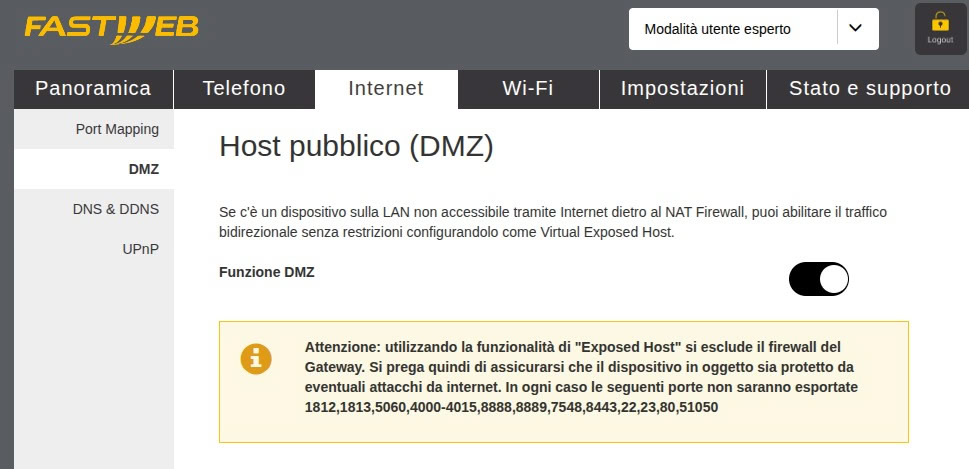
Al secondo tentativo, con il cuore che batte per l’assurdità del gesto, entro e provo a configurare quello che oggi, con un termine che nasconde l’ignoranza tecnica sotto un velo di modernità, è chiamato DMZ ma che resta un NAT 1:1.

“Senza restrizioni”, dice la descrizione. Eppure non posso nemmeno lasciarmi martellare la porta 22 da un bot cinese per puro diletto. Così ho staccato tutto e ho collegato l’ONT direttamente al mio Mikrotik 5009, gettando via quella scatola del piacere per scimmie allo zoo chiamata “Fastgate”.

Il marketing dell’ignoranza

Capitolo 1: Vogliamo WiFi! (cit.)

Ovvero: quando Bello Figo diventa il direttore marketing di tutti gli ISP italiani mainstream: https://www.youtube.com/watch?v=aR7EK2cYnPk

Viviamo in un’era dove tutto è “WiFi”. Da Sky a TIM, ogni offerta ha perso il contatto con la realtà fisica dei cavi e dell’infrastruttura per abbracciare un’astrazione commerciale che si adatta a un popolo che non vuole più capire.

https://www.youtube.com/watch?v=9oIDAeXqkH0

Ho sentito ragazzi in età universitaria parlare di “abbonamento al wifi”, come se l’infrastruttura fosse svanita nell’etere. È una semplificazione che uccide la cultura tecnica, trasformandola in una melassa indistinguibile.

Capitolo 2: admin:admin

E poi c’è la questione dei due pulsantini. Una scelta “passwordless” che è, tecnicamente parlando, una cagata pazzesca. È scomoda coma la carta igienica da un velo fatta di carta riciclata, ma è soprattutto pericolosa.

Immaginate una festa a casa vostra, la password del WiFi che gira come figurine Panini negli anni ’90. Un amico di amici, quello bravo col computer, con un’App colorata scaricata dall’app store, fa una scansione di rete e vi becca l’NVR delle telecamere di videosorveglianza. Mentre siete distratti a ridere, lui si avvicina al modem e preme quei maledetti tasti per tre secondi. In un istante è dentro. Si configura un port-forwarding verso l’NVR e torna da voi al barbecue, a mangiare salsicce e a chiedervi del vostro cane.

Torna a casa, vi bruteforza la password delle telecamere che, se non è admin o 123456 è quasi certamente il nome di quella bestiola che gli avete presentato. A questo punto la vostra vita privata è su internet. Grazie anche ai pulsantini di Fastweb!

Capitolo 3: Devo andare a prendere Bubba!

Il NAT 1:1 (o 1:1 Network Address Translation) si limita a mappare un indirizzo IP pubblico su uno privato, mantenendo l’esatta corrispondenza dei numeri di porta. È quella funzionalità che nei router casalinghi viene spacciata per “DMZ” solo per dare un nome altisonante a un’operazione di sostituzione di indirizzi dai pacchetti in transito. Evidentemente NAT gli stava sul cazzo.

La vera DMZ (Demilitarized Zone), invece, è una sottorete ben precisa di un firewall, esposta su internet ma rigorosamente isolata dalle altre reti interne. È un’architettura di sicurezza, non una semplice regola di traduzione indirizzi. Non è la funzionalità del vostro modem. Ma allora perché la chiamano DMZ? Forse per quell’abitudine tutta moderna di usare parole grandi per coprire realtà piccole, o forse perché nel marketing dell’ignoranza la precisione è un rumore di fondo che disturba il messaggio.

Capitolo 4: L’eutanasia della curiosità

Perché abbiamo smesso di pretendere la precisione? Forse perché è più comodo affogare in un’interfaccia colorata che guardare nell’abisso della configurazione. Ci siamo arresi a una fruizione passiva, un’esistenza dove capire è diventato un optional trascurabile.

Il RANT è finito.

Liberiamo il router

La delibera AGCOM n. 348/18/CONS (in vigore dal 31 dicembre 2018) sancisce il diritto in Italia del modem libero. Gli utenti possono scegliere e utilizzare un modem/router alternativo a quello fornito dall’operatore, senza costi aggiuntivi, penali o discriminazioni tecniche, garantendo la libera scelta dell’apparecchiatura terminale.

La delibera AGCOM 348/18/CONS sancisce il diritto al modem libero. Una su mille l’hanno azzeccata.

La documentazione ufficiale di Fastweb è volutamente caotica: il loro interesse è tenervi legati al loro router per semplicità di gestione. Dicono che con il modem libero non sarà possibile usare l’IPv6.
Cito: “Nel caso di utilizzo di un modem-router non fornito da Fastweb non sarà possibile usufruire dei […] servizi aggiuntivi specializzati Fastweb previsti dall’offerta, quali ad esempio il servizio IPV6.”
Ovviamente non è un limite tecnico assoluto; dipende da quanto è evoluto il vostro router. Infatti, lo configuriamo.

IPv4

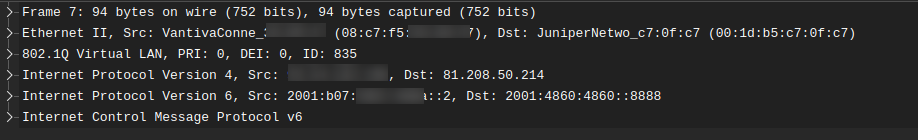
Sniffando il traffico tra ONT e router si vedono le VLAN 200 e 835. La 835 è quella che ci interessa. Fastweb usa l’autenticazione IPoE con mac-address invece del classico tunnel PPPoE. IPoE non ha bisogno di credenziali per ogni cliente e non mangia MTU con l’incapsulamento.

Per prima cosa bisogna clonare il mac-address della WAN del router ufficiale. Non serve fare M-i-t-M tra router e ONT, basta osservare il traffico con Wireshark perché l’interfaccia non è silente:

  • c’è del traffico IEEE-1905 untagged (un errore di configurazione loro, secondo me, perché credo che questo traffico debba esistere solamente lato LAN, si saranno scordati di mettere una bella policy tagged-only)
  • c’è DHCP Discover sulla VLAN 835
  • c’è ICMPv6 Neighbor Solicitation sulla VLAN 200

Preso il mac-address, lo assegniamo all’interfaccia WAN e creiamo una VLAN figlia con ID 835, affiancandoci un DHCP Client. Fine. Abbiamo IPv4 con MTU pieno a 1500.

/interface vlan
  add interface=ether1 name=vlan835 vlan-id=835
/ip dhcp-client
  add interface=vlan835

IPv6

Ho visto provider che hanno dual-stack sia su PPPoE che IPoE, probabimente dipende dal segmento della rete GPON su cui siete e non tanto dal provider.
Nel mio caso il servizio nativo è solo IPv4.

Per avere IPV6 bisogna quindi fare un tunnel 6rd (IPv6 Rapid Deployment) che è una estensione del 6to4. Si tratta di incapsulamento, che mangia 20 byte di overhead (la dimensione dell’header IPv4). L’MTU della connettività IPv6 sarà quindi 1480 (1500-20).

Alcune caratteristiche di un tunnel 6rd:

  • Setta il flag del protocollo IPv4 a 41 come 6to4
  • 6to4 utilizza il prefisso riservato 2002::/16, mentre 6rd utilizza un prefisso dell’ISP, quello di Fastweb è 2001:b07::/32. L’indirizzo IPv6 viene ricavato incorporando l’indirizzo IPv4 in notazione esadecimale, aggiungendo il suffisso ::2 e chiaramente il prefix /64 che è l’unità minima routabile in IPv6.
  • 2001:b07::/32 fa parte di 2000::/3, ovvero gli indirizzi Global Unicast assegnati dai vari registri (RIPE, ARIN, ecc.) per il traffico IPv6 nativo.
  • L’endpoint del tunnel 6rd di Fastweb è 81.208.50.214 che poi farà da Relay Router sulla rete IPv6 nativa.
   6rd specifies a protocol mechanism to deploy IPv6 to sites via a
   service provider's (SP's) IPv4 network.  It builds on 6to4 [RFC3056],
   with the key differentiator that it utilizes an SP's own IPv6 address
   prefix rather than a well-known prefix (2002::/16).  By using the
   SP's IPv6 prefix, the operational domain of 6rd is limited to the SP
   network and is under its direct control.  From the perspective of
   customer sites and the IPv6 Internet at large, the IPv6 service
   provided is equivalent to native IPv6.

A differenza di un 6to4, l’indirizzo di un 6rd fa sembrare il traffico IPv6 nativo.

Per calcolare la /64 si converte l’IPv4 in esadecimale. Esempio: 10.11.12.13 diventa 0A0B:0C0D. L’indirizzo sarà 2001:b07:0a0b:0c0d::2/64.

/interface 6to4
  add mtu=1480 name=6rd-fastweb remote-address=81.208.50.214
/ipv6 address
  add address=2001:b07:OMISSIS:OMISSIS::2 advertise=no interface=6rd-fastweb

Per vostra curiosità, questo è il contenuto del frame che sta trasmettendo quel ping:

  • 15 byte di header Ethernet
  • 4 byte di vlan
  • 20 byte di header IPv4
  • 40 byte di header IPv6
  • 16 byte di ICMPv6

MTU

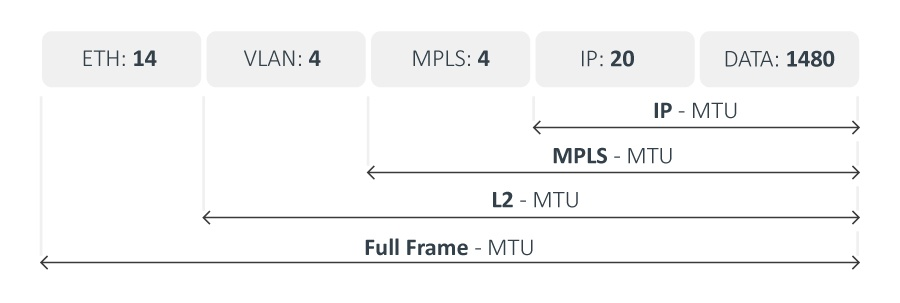
Mentre l’MTU è standardizzato dagli RFC 791 (IPv4) e RFC 8200 (IPv6) come la somma dell’header IP + Dati, l’L2MTU non lo è.

In Mikrotik, l’L2MTU non tiene conto dei 14 byte dell’header Ethernet, mentre il Full Frame MTU rappresenta la lunghezza reale sul cavo. Altri vendor inglobano i 14 byte dell’header L2 nel conteggio, altri ancora includono pure i 4 byte di checksum, ecc.

Considerando la massima dimensione del pacchetto IPv6 a 1480 abbiamo:

  • IPv6 MTU (1480): IPv6 (40 byte) + Data: (1440)
  • IPv4 MTU (1500): IPv4 (20 byte) + IPv6 (40 byte) + Data: (1440)
  • L2MTU (1504): Vlan (4 byte) + IPv4 (20 byte) + IPv6 (40 byte) + Data: (1440)
  • FullFrame MTU (1518): Ethernet (14 byte) + Vlan (4 byte) + IPv4 (20 byte) + IPv6 (40 byte) + Data: (1440)

Per IPv4:

  • IPv4 MTU (1500): IPv4 (20 byte) + Data: (1480)
  • L2MTU (1504): Vlan (4 byte) + IPv4 (20 byte) + Data: (1480)
  • FullFrame MTU (1518): Ethernet (14 byte) + Vlan (4 byte) + IPv4 (20 byte) + Data: (1480)

L’L2MTU impostato di default sul mio modello è 1514 (configurabile fino a un massimo di 9796) ed è sufficiente in quanto 1514 >= 1504.

Enjoy!

La cybersecurity non è più cosa da hacker – il caso GoSign di Tinexta InfoCert

English version: here

C’è stata un’epoca, fino ai primi anni 2000, in cui chi si occupava di sicurezza informatica lo faceva perché non poteva farne a meno. Non per il mercato, non per le certificazioni, non per una carriera nel settore. Lo faceva perché era finito dentro un mondo strano, pieno di persone curiose, spesso sregolate, ma animate da un’irrefrenabile voglia di capire come funzionavano davvero le cose, e soprattutto, di condividere e confrontarsi.

Era un ecosistema vivo, underground, dove ogni scoperta diventava automaticamente anche la scoperta di qualcun altro. Dove lo spirito hacker – quello vero, fatto di collaborazione e confronto – era più importante del titolo sul biglietto da visita.

Oggi, guardando come si è trasformato il settore, questo spirito sembra evaporato.

Non perché manchino persone competenti: al contrario.
Il cambio generazionale porta nei reparti cyber delle aziende figure con un background accademico, master, certificazioni e un CV luccicante su LinkedIn. Ma manca qualcosa. Manca quel senso di comunità, di “noi contro la complessità del mondo”, che ha sempre fatto da collante.

E quando questo spirito manca, si vede. Si vede nelle community che si sgretolano, e poi muoiono. Si vede nei vendor che reagiscono alle segnalazioni di sicurezza come se fossero rotture di scatole da minimizzare invece che occasioni di miglioramento, come quello che ho vissuto sulla mia pelle con GoSign Desktop di Tinexta InfoCert.

Un caso che racconta (purtroppo) il presente

GoSign Desktop è un software di firma digitale usatissimo: pubbliche amministrazioni, aziende, professionisti. Migliaia di documenti firmati ogni giorno.

A inizio ottobre di quest’anno (2025) ho trovato due problemi seri in GoSign Desktop (versioni <= 2.4.0):

  • la verifica TLS veniva disattivata quando si utilizzava un proxy (molto comune in ambienti enterprise);
  • il meccanismo di aggiornamento si basava su un manifest non firmato.

In pratica: chiunque in grado di eseguire un MitM poteva:

  • intercettare e leggere traffico;
  • fornire un manifest “falso” contenente un aggiornamento malevolo;
  • far eseguire codice arbitrario sulla macchina della vittima.
    • Su Windows e Mac con i privilegi dell’utente.
    • Su Linux con privilegi root.

Inoltre, su Linux esiste anche un altro scenario di Local Privilege Escalation, sfruttabile a prescindere dall’impostazione “proxy” di GoSign.

Un disastro annunciato.

Link alla disclosure ufficiale.

Responsible Disclosure (unidirezionale)

Faccio quello che ogni ricercatore serio fa: segnalo la vulnerabilità al vendor, condivido dettagli, PoC, mitigazioni. Mi rendo disponibile per una call tecnica il 16 ottobre, dove il responsabile della sicurezza e il product owner mi confermano tutto. Insieme fissiamo una deadline a fine mese per la patch.

Non ho chiesto soldi, se fosse stato possibile una citazione nel ChangeLog – come si fa in questi casi – sarei stato grato.

Ad ogni modo, rimanevo in attesa di una loro comunicazione che mi avvisava della patch pronta, di modo da poter pubblicare l’advisory della vulnerabilità senza alcun rischio per gli utenti.

E qui la storia si interrompe.
O meglio: si interrompe da parte di Tinexta Infocert S.p.A.

Dopo quella call in cui ho condiviso tutti i dettagli tecnici pro-bono, il silenzio. Nessun aggiornamento. Nessuna risposta alle email. Nessun confronto.

Poi, il 4 novembre, esce la versione 2.4.1. Me ne accorgo qualche giorno dopo. Versione che includeva proprio la fix da me proposta pubblicata in silenzio, senza alcun avviso, senza nessuna menzione, senza riconoscere il lavoro di chi ha segnalato il problema, senza nemmeno un messaggio a dire “ok, è uscita”.

Una gestione che definire scorretta è un eufemismo.
Una gestione che racconta benissimo lo stato del settore.

Perché?

Perché in uno scenario sano, basato sulla fiducia reciproca, un vendor sarebbe grato. Collaborerebbe. Si confronterebbe. Riconoscerebbe.
Invece oggi la sicurezza sembra diventata un pezzo del ciclo di prodotto: qualcosa da chiudere in fretta, minimizzare, mettere a tacere.

ACN/CSIRT Italia è stata informata dell’accaduto, sia della vulnerabilità che del comportamento scorretto del vendor. Ed era giusto così.

Oltre GoSign

Questa storia non è interessante solo per le vulnerabilità – gravi – o per la disclosure gestita male.

È interessante perché è simbolica. È un esempio del mondo che resta quando lo spirito hacker scompare: un mondo freddo, aziendalista, senza empatia, dove chi segnala un problema, mettendo a disposizione le sue competenza gratuitamente, è visto come un rischio reputazionale invece che come un alleato.

Ed è paradossale, perché la sicurezza – e in questo caso anche un pezzo di sicurezza nazionale – dipende proprio da chi ha ancora quella mentalità lì: persone indipendenti, curiose, che dedicano tempo libero e competenze a controllare ciò che nessuno controlla. Persone che fanno ricerca pro-bono, senza strutture, senza budget, senza team di product management.

Persone che lo fanno perché credono che, se c’è qualcosa che non funziona, è giusto segnalarlo per portare un miglioramento a beneficio di tutti.

Quello che abbiamo perso

Abbiamo perso il senso di responsabilità collettiva.
Abbiamo perso la capacità di discutere senza filtri.
Abbiamo perso l’idea che la sicurezza sia un bene comune, non un asset commerciale da proteggere dietro una muraglia di NDA.

E quando il settore si riempie di professionisti top-down, cresciuti più nell’accademia che nel fango delle community, succede questo: si diventa bravissimi a fare threat modeling, e incapaci di parlare con chi ti sta dando una mano.

Perché manca l’empatia.
Manca la cultura del confronto.
Manca lo spirito.

La cybersecurity non è più cosa da hacker. Ed è un problema.

Perché senza hacker – quelli veri, non quelli disegnati come personaggi cattivi nelle slide aziendali – rimane solo un settore pieno di regole, procedure, KPI… e vuoti enormi. Vuoti e buchi che nessuno vede.